24GB 显卡跑 32B 量化模型:vLLM 与 llama.cpp 选型对比
内容标识:本文为 AI 辅助生成内容。依据 《人工智能生成合成内容标识办法》2025-09-01,已添加显式标识(本声明)与隐式标识(文件元数据 / 图片 ComfyUI 元信息)。文中技术细节与结论均由作者复核确认。
我们用 Ollama 在 PVE 虚拟机上跑通了本地大模型(参见用 Ollama 在 PVE 虚拟机里跑本地大模型:显卡直通与显存规划)。但需求升到 32B 级别、要多人并发调用时,Ollama 就不够用了,主流选择是 vLLM(高并发服务化)与 llama.cpp(低资源单机)。
很多人默认这是一道自由选择题,二选一即可。但动手前必须先确认一件事:你那张 24GB 卡属于哪一代架构——这一条几乎直接决定框架能不能跑起来。
测试环境:一台 HP Z440 工作站 + 三张老卡
本文的环境就是手边这台 HP Z440 塔式工作站,那张 24GB 的卡是 NVIDIA Quadro M6000。
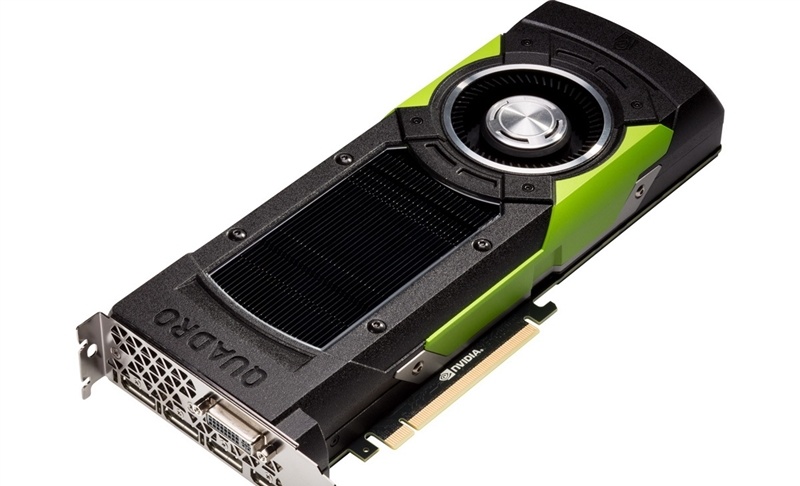
图 1:NVIDIA Quadro M6000 24GB 显卡。图片来源:NVIDIA 官方产品资料,仅作型号外观示意(非本机实拍)。
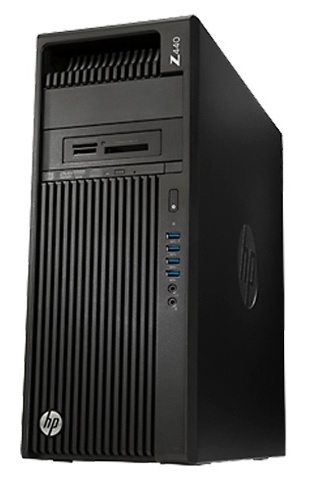
图 2:测试主机 HP Z440 塔式工作站。图片来源:中关村在线(ZOL)产品图,仅作型号外观示意。
| 部件 | 型号 | 计算能力 | 角色 |
|---|---|---|---|
| 主机 | HP Z440 塔式工作站(Xeon E5 v3/v4 平台、C612 芯片组) | — | 测试平台 |
| 主角显卡 | NVIDIA Quadro M6000 24GB | 5.2(Maxwell) | 本文讨论的 24GB 卡 |
| 同机显卡 | NVIDIA GTX 1050 | 6.1(Pascal) | 亮机 / 轻量任务 |
| 同机显卡 | NVIDIA Tesla P4 8GB | 6.1(Pascal) | 被动散热计算卡 |
这张表里埋着一个对选型很关键的细节:三张卡的计算能力全部低于 7.0(5.2 / 6.1 / 6.1)。也就是说,这台机器上无论换用哪张卡,都迈不过 vLLM 的门槛。
作为对照,上一篇文章里用于图片生成实测的那台机器是 RTX 4070 Ti SUPER 16G(Ada 架构、算力 8.9),属于 vLLM 支持的范围。
先纠正一个常见误判:M6000 是 Maxwell,不是 Pascal
Quadro M6000 24GB 常被和 Pascal 混为一谈(我自己也一直记成 Pascal)。它的真实身份是 GM200 核心、Maxwell 2.0 架构,计算能力(Compute Capability)5.2,2016 年 3 月发布,24GB GDDR5、384-bit 位宽、带宽约 317 GB/s。
这个差异是选型分水岭:
| 架构 | 计算能力 | 代表卡 | 对本文的意义 |
|---|---|---|---|
| Maxwell | 5.0 / 5.2 | M6000 24G、GTX 9xx | llama.cpp 可用,vLLM 不支持 |
| Pascal | 6.0 / 6.1 | GTX 10xx、Tesla P40 | llama.cpp 可用,vLLM 需改源码 |
| Volta 及以后 | ≥ 7.0 | V100、T4、RTX 20xx+ | 两套框架都能用 |
vLLM 在 M6000 上直接出局
vLLM 官方安装文档对 GPU 的要求很直白:计算能力 7.0 或更高,示例列举 V100、T4、RTX 20xx、A100、L4、H100。
也就是说,预编译轮子覆盖的是 Volta(7.0)及更新的卡,Pascal 及更早(Maxwell)不在支持范围。社区确实有改源码让 vLLM 跑 Pascal 的做法,但 M6000 还要再往前退一代,改造投入与实际收益不成比例。
结论:在 M6000 上,「vLLM 与 llama.cpp 对比」这个命题并不成立,vLLM 在第一关就被硬件门槛拦下。非要用 vLLM,就得换一张计算能力 ≥ 7.0 的卡(如二手 T4 / RTX 2080Ti)。
llama.cpp 是 M6000 上唯一现实的选择
llama.cpp 的 CUDA 后端要求宽松得多:计算能力 ≥ 5.0(Maxwell 或更新)即可,Maxwell 在官方支持表中被标注为 Legacy(传统支持)。
关键是显式指定编译架构,否则默认 fatbin 里可能没有 sm_52 原生代码,运行时靠 PTX JIT 翻译,速度会明显吃亏:
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
cmake -B build -DGGML_CUDA=ON -DCMAKE_CUDA_ARCHITECTURES="52"
cmake --build build --config Release -j$(nproc)还有一条易被忽略的硬约束:CUDA 工具链必须停留在 12.x。Maxwell/Pascal/Volta 已被列为弃用架构,CUDA 13.x 的最低要求是 Turing(sm_75),为 M6000 编译不能再升到 13。
启动服务只需一条命令(自带 OpenAI 兼容接口):
./build/bin/llama-server
  -m /data/models/qwen2.5-32b-instruct-q4_k_m.gguf
  -ngl 99 -c 8192 --port 8080
性能预期:带宽是硬约束
自回归解码是典型的显存带宽瓶颈任务。M6000 带宽约 317 GB/s,RTX 3090 约 936 GB/s,前者只有后者三分之一。按此粗估,32B Q4_K_M 在 M6000 上的出词速度大约在每秒几个 token 到十个 token 之间,首 token 延迟也更长。
要强调:以上是按带宽比推算的估算值,并非本机实测数字。CUDA 版本、是否命中原生 sm_52 代码、上下文长度都会显著影响结果,请以本机 llama-bench 实测为准。
选型建议
| 场景 | 推荐 | 理由 |
|---|---|---|
| M6000(Maxwell 5.2)24G | llama.cpp | vLLM 有 7.0 算力门槛,跑不起来 |
| 单人自用、追求省事 | llama.cpp | 部署简单,GGUF 生态丰富 |
| 多人并发 API 服务 | vLLM | 需计算能力 ≥ 7.0 的卡,连续批处理带来数倍吞吐 |
一句话总结:框架没有绝对优劣,只有场景匹配。M6000 这类老卡的价值是「24GB 显存便宜」,代价是架构代差带来的兼容性收窄——先确认架构代次,再选框架,能省下大量折腾。图片生成环境搭建可参考本站的 ComfyUI 本地部署指南,思路相通。