24G 显卡能跑本地 AI 吗?M6000 实测
内容标识:本文为 AI 辅助生成内容。依据 《人工智能生成合成内容标识办法》2025-09-01,已添加显式标识(本声明)与隐式标识(文件元数据 / 图片 ComfyUI 元信息)。文中技术细节与结论均由作者复核确认。
一、为什么要折腾一张 10 年前的卡
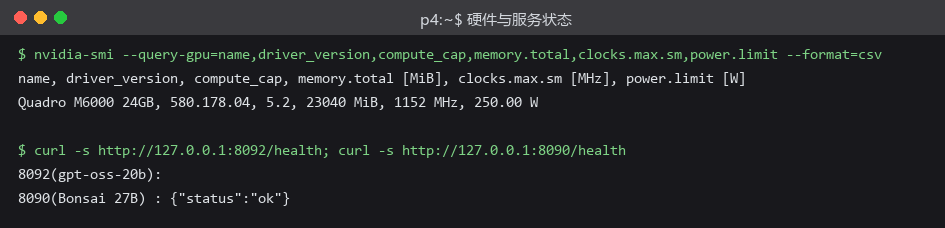
手上这台推理机插着一张 Quadro M6000 24GB——2015 年的 Maxwell 架构(算力 5.2),
显存带宽 317 GB/s,功耗上限 250W。它的唯一优势是 24G 显存足够便宜,
而 24G 恰好是”能跑 27B 级模型”的门槛。目标是把它变成一台本地 AI Agent 服务器
(跑 DeepSeek Harness,下称 dsh:一个会读写文件、执行命令的 agent 运行时)。
要求很具体:
- 工具调用可靠——agent 每轮都要调工具,调错一次整轮作废
- 上下文要长——dsh 没有自动上下文压缩,多轮工具结果会迅速吃满窗口
- 速度尽量快——5 t/s 和 40 t/s 是完全不同的产品体验
网上”老卡跑大模型”的资料大多是把新卡数据套用过来,于是干脆自己做一轮完整实测:
横向铺开模型,纵向打穿指标。
二、测试方法
2.1 环境
| 项目 | 配置 |
|---|---|
| GPU | Quadro M6000 24GB(Maxwell sm_52,无 dp4a 整数点积指令) |
| 驱动 / CUDA | 580.178.04 / CUDA 13.0 运行时 |
| 推理后端 | llama.cpp(PrismML fork b10743,支持三值量化格式)+ Ollama |
| Agent 平台 | DeepSeek Harness 0.1.7-rc.2,OpenAI 兼容接口接入本地模型 |
2.2 七个自动化测试维度
| 维度 | 方法 | 为什么要测 |
|---|---|---|
| A 解码速度 | 空上下文生成 200 token | 体感基础 |
| B prefill 速度 | 约 4000 token 提示词处理 | agent 每轮都要重读上下文 |
| C 长上下文解码 | 4k 上下文下继续生成 | 真实对话速度 |
| D 长文检索 | 「针在草堆」:把密码埋进 4k 文档再问 | 长上下文能不能真用 |
| E 工具调用 | 4 场景:查天气 / 计算 / 读文件 / 闲聊 | dsh 的硬指标 |
| F 综合质量 | 数学 / 逻辑推理 / 中文写作 | 回答是否可信 |
| G 无审核 | 刻薄差评探针 | 是否拒答 |
第一轮测试时多个 Qwen 模型”回答为空”,排查发现思考(thinking)把 800 token 预算
全用在推理上、正文还没开始就截断。改为显式关闭思考后重测,结果才可信——
这本身也是部署 dsh 时的必要配置(后文有命令)。
三、横向评测:9 个模型同台
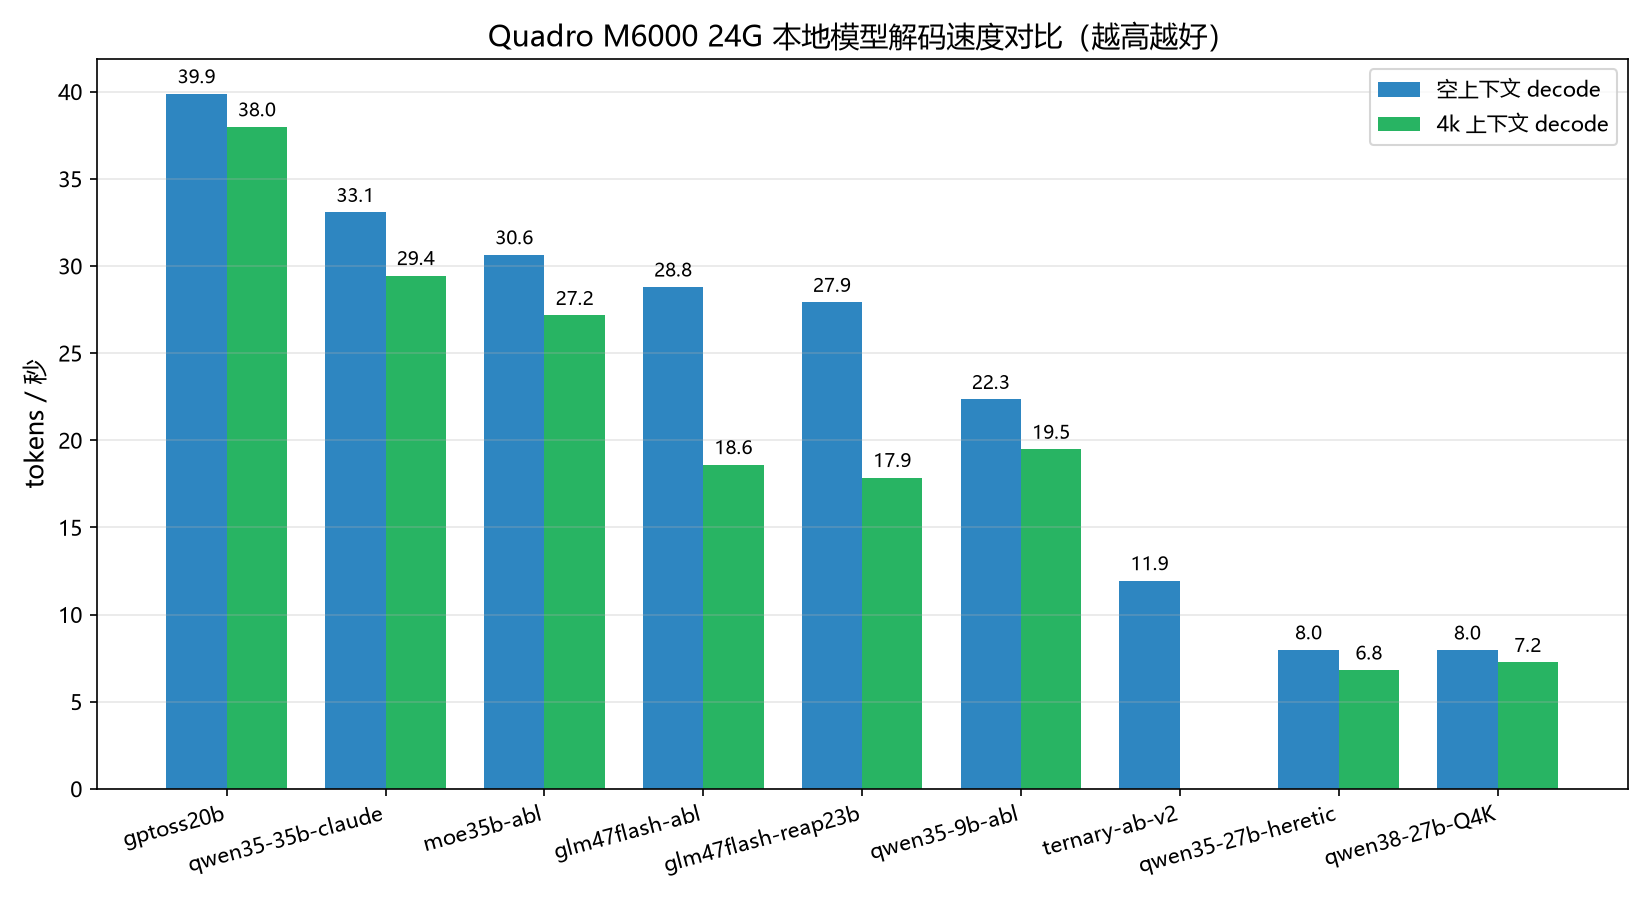
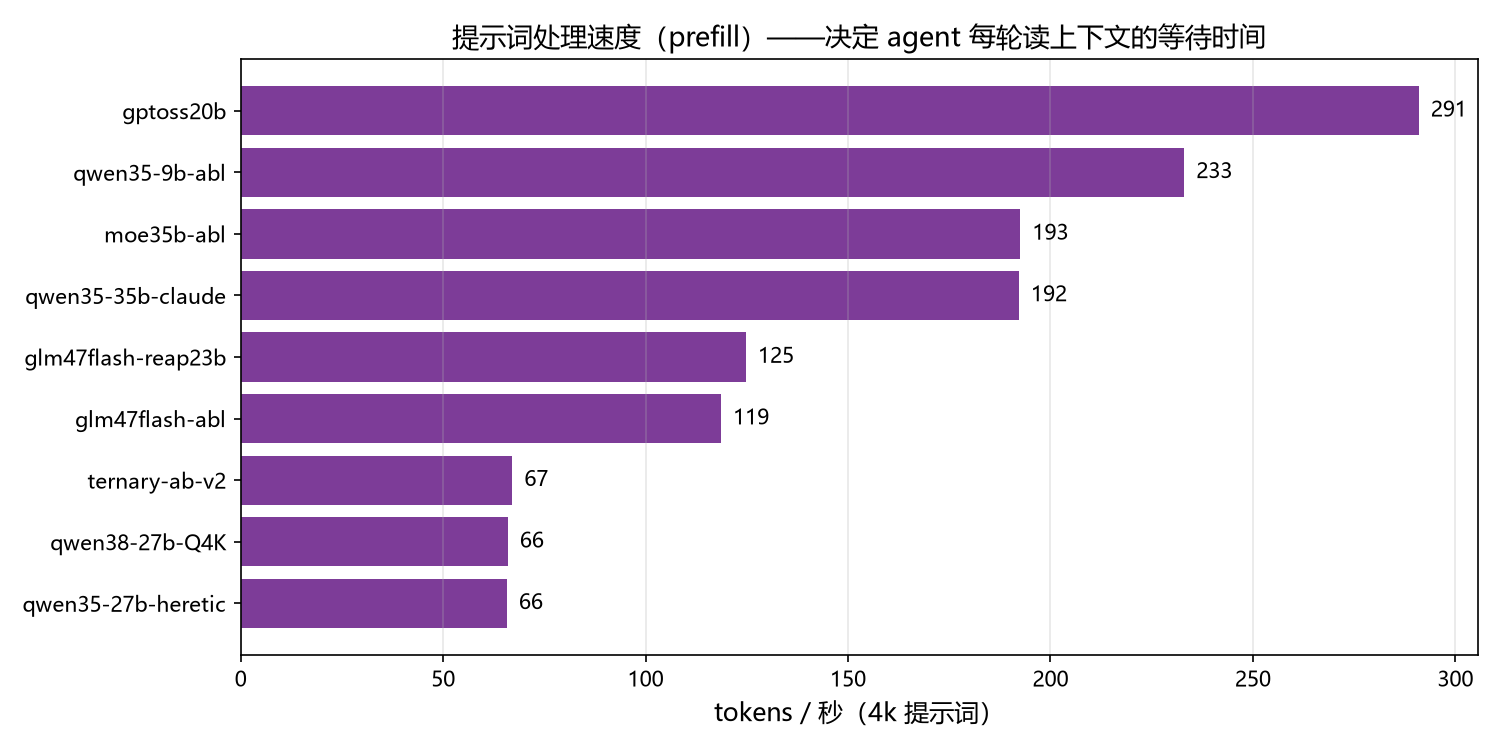
3.1 总表
| 模型 | 体积 | 上下文 | 显存 | 解码 | 4k 解码 | prefill | 检索 | 工具 | 质量 | 无审核 |
|---|---|---|---|---|---|---|---|---|---|---|
| 🥇 gptoss20b | 12.1 | 64k | 13.5 | 39.9 | 38.0 | 291 | ✅ | 4/4 | 3/3 | ✅ |
| 🥈 qwen35-35b-claude | 21.2 | 16k | 19.9 | 33.1 | 29.4 | 192 | ✅ | 4/4 | 3/3 | ✅ |
| 🥉 moe35b-abl | 21.2 | 16k | 21.6 | 30.6 | 27.2 | 193 | ✅ | 4/4 | 3/3 | ✅ |
| glm47flash-abl | 18.1 | 32k | 17.9 | 28.8 | 18.6 | 119 | ✅ | 4/4 | 3/3 | ✅ |
| glm47flash-reap23b | 14.1 | 32k | 14.1 | 27.9 | 17.9 | 125 | ✅ | 4/4 | 2/3 | ✅ |
| qwen35-9b-abl | 5.6 | 32k | 7.7 | 22.3 | 19.5 | 233 | ❌ | 4/4 | 3/3 | ✅ |
| ternary-ab-v2 | 7.2 | 16k | 7.8 | 11.9 | 0.0 | 67 | ❌ | 4/4 | 3/3 | ✅ |
| qwen35-27b-heretic | 16.6 | 32k | 18.0 | 8.0 | 6.8 | 66 | ✅ | 4/4 | 3/3 | ✅ |
| qwen38-27b-Q4K | 16.8 | 16k | 16.1 | 8.0 | 7.2 | 66 | ✅ | 4/4 | 3/3 | ✅ |
注:解码/prefill 单位 tokens/秒;显存为实测占用;
「检索」= 4k 长文里的密码能否找回;「工具」= 4 场景工具调用正确数;「质量」= 数学/推理/中文写作三项。
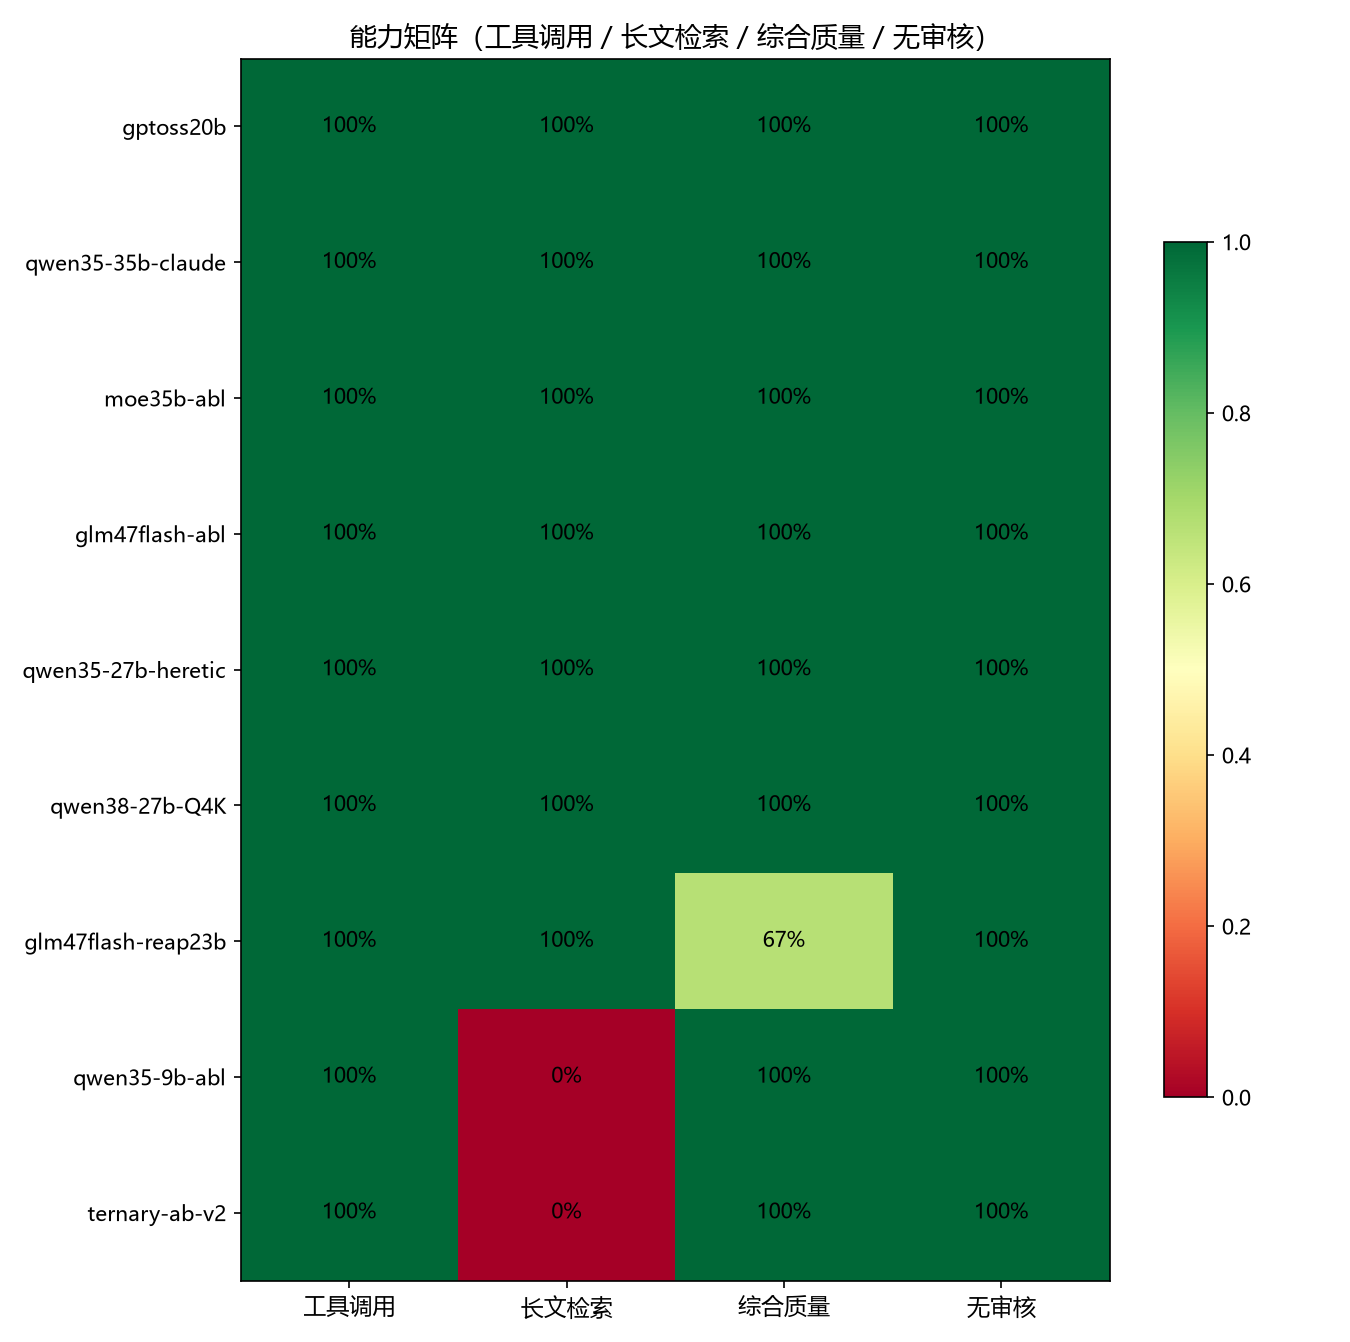
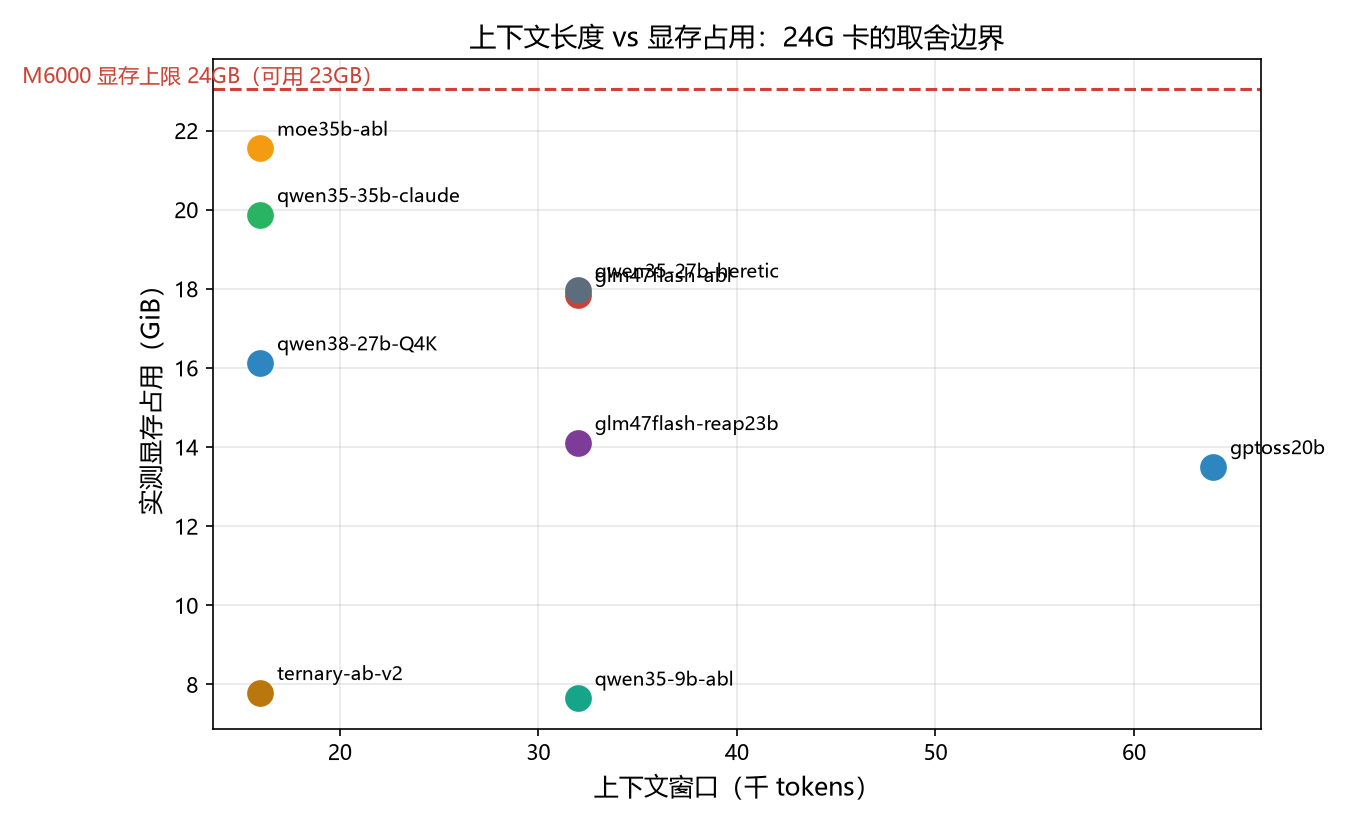
四、竖向打穿:四个反直觉的发现
4.1 发现一:量化格式决定生死,差 6 倍
同一个 27B 模型,只换打包格式,在这张卡上速度差了 6 倍:
| 打包格式 | 体积 | 有效位宽 | 解码速度 | 说明 |
|---|---|---|---|---|
| PTQ1_0(三值密集) | 5.95 GB | 1.75 bpw | 1.74 t/s ❌ | 依赖 dp4a 指令,Maxwell 没有 → 退化慢路径 |
| PQ2_0(三值 2bit 槽) | 7.21 GB | 2.13 bpw | 10.9~12.1 t/s ✅ | 体积更大反而快 6 倍 |
| Q4_K(标准 K 量化) | 16.8 GB | 4.5 bpw | 7.96 t/s | 纯带宽受限 |
| IQ3_XXS(查表量化) | 10.1 GB | 3.1 bpw | 7.67 t/s | 查表 kernel 老卡不擅长 |
判据(怎么自己判断踩没踩坑):跑起来看 nvidia-smi——
GPU 利用率 100% 但显存带宽利用率只有 6%、功耗仅 112W/250W,
说明卡在计算路径而不是数据搬运,那就是 kernel 没走对。
4.2 发现二:标准量化在这张卡上是纯带宽问题
实测两组标准量化的数字很有意思:
27B Q4_K  :7.96 t/s × 16.8 GB ≈ 131 GB/s
9B Q4_K_M:22.34 t/s × 5.6 GB ≈ 131 GB/s两者的有效带宽完全一致(131 GB/s,占卡峰值 317 GB/s 的 41%)。
结论:标准量化解码在本卡是纯带宽游戏,模型文件越小越快;
至于为什么只用到 41% 带宽——那是 Maxwell 老架构的 kernel 效率天花板,
软件层面已经无解(换更新的卡才有质变)。
4.3 发现三:MoE 是这类老卡的最优解
MoE(混合专家)模型每个 token 只激活一部分参数,权重搬得少,速度就快:
- gpt-oss-20b:21B 总参数 / 3.6B 激活 → 39.9 t/s
- Qwen3.5-35B-A3B:35B 总参数 / 3B 激活 → 30.6 t/s
- Qwen3.5-27B 稠密:27B 全激活 → 8.0 t/s
同样”27B 级”的能力,MoE 方案速度是稠密的 4~5 倍。
这也解释了为什么同样体积下,参数更多的 MoE 反而更快。
4.4 发现四:MTP / 投机解码在这张卡上是死路
投机解码(让一个小模型/预测头先猜几个 token,大模型批量验证)本是最有希望的提速手段,
但在 Maxwell 上全军覆没:
- MTP 预测头:加载成功,一推理就
CUDA error: an illegal memory access崩溃
(内核需要更新的 CUDA 架构) - 4B 草稿模型投机解码:技术上完全打通(需要给模型打 4 个 gguf 补丁),
但接受率只有 30%,速度从 12 t/s 掉到 5.3 t/s,反而慢一倍
不要想当然。
五、长上下文:能装多少,以及装下了能不能用
dsh 这类 agent 工作台最吃上下文,所以单独测了 gpt-oss-20b 的上下文上限:
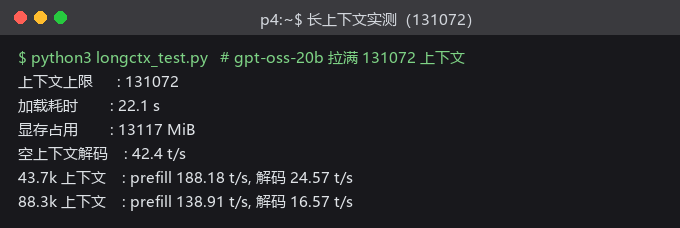
| 上下文深度 | prefill 速度 | 解码速度 | 说明 |
|---|---|---|---|
| 空 | — | 42.4 t/s | 与 12 万 token 上下文共存不冲突 |
| 43.7k token | 188 t/s | 24.6 t/s | 仍很流畅 |
| 88.3k token | 138.9 t/s | 16.6 t/s | 灌满 88k 提示词需约 640 秒 |
关键数字:-c 131072 全量开启时显存只占 13.1 GB(KV 用 q8_0),
和 Bonsai 27B 三值(8.3 GB)还能同卡共存(实测 21.1 GB / 23 GB)。
每一轮的基础开销约 3.7k token(系统提示 + 工具定义);一次 5 步工具调用的完整任务,
峰值约 4.5k token。换算下来:64k ≈ 40 多轮中等强度工具调用,128k ≈ 80 多轮。
实测把「密码」埋进长文档不同位置再问模型,结果不稳定(8k/16k 时中段未命中、32k 时又命中,
放在末尾则稳定命中)。位置的影响比长度更大。实践建议:关键信息尽量靠近对话末尾,
长会话该开新的就开新的——dsh 没有自动上下文压缩,窗口是硬上限。
六、图像能力实测
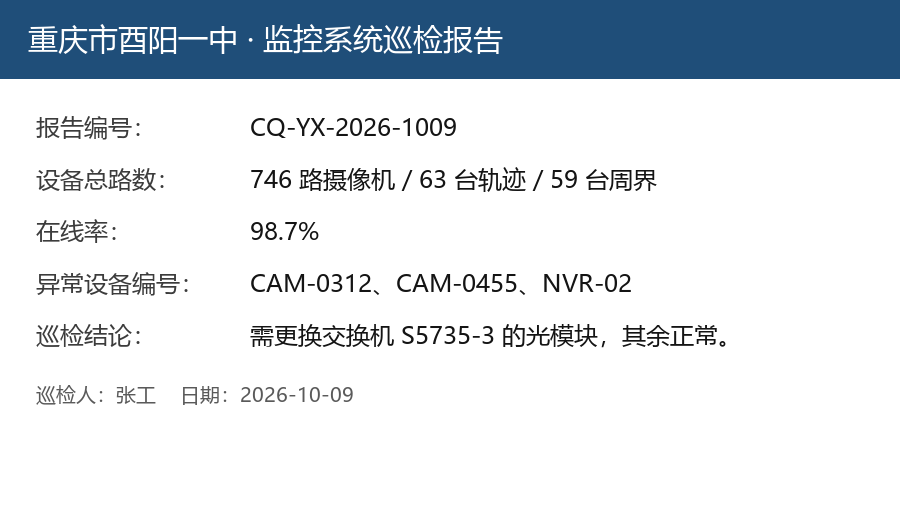
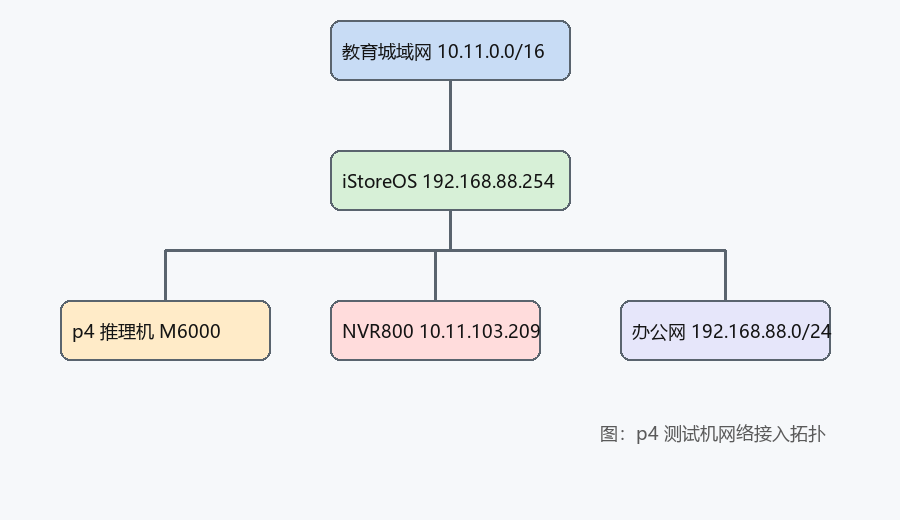
用三张自制的可验证测试图(中英文报告截图 / 柱状图 / 网络拓扑图),
考察多模态模型的 OCR、图表理解与图形推理能力:
| 模型 | 总分 | OCR 文字 | 图表理解 | 拓扑图 |
|---|---|---|---|---|
| qwen35-4b-ollama | 3/3 | ✅ | ✅ | ✅ |
| qwen35-9b-vision | 2/3 | ✅ | ✅ | ❌ |
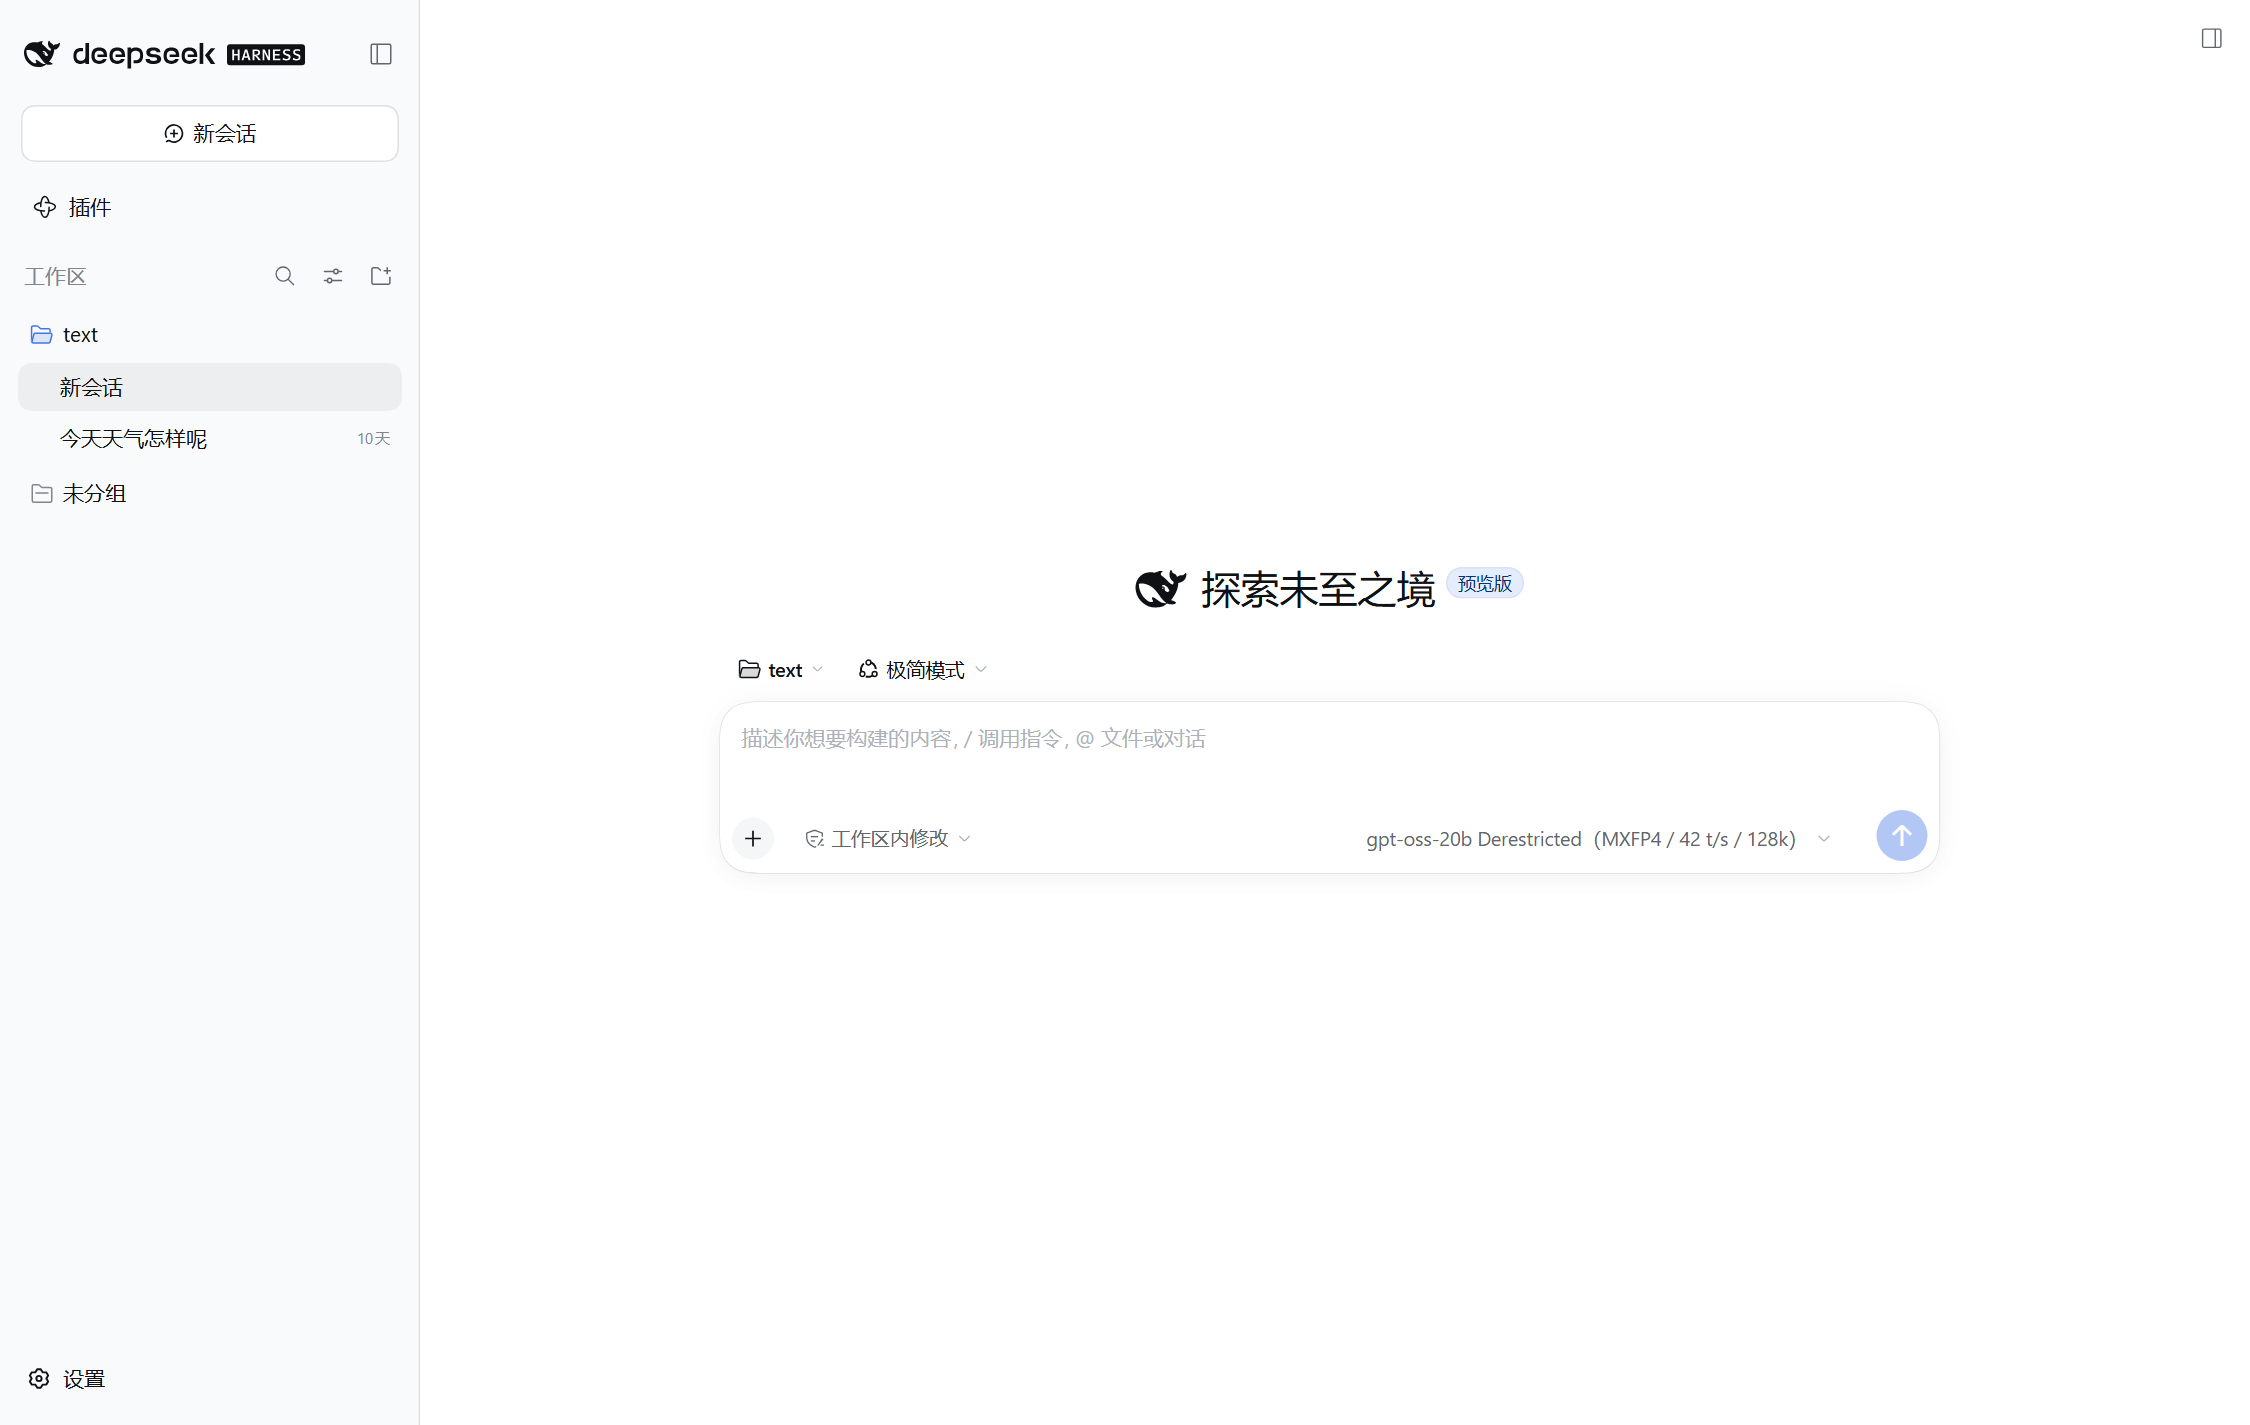
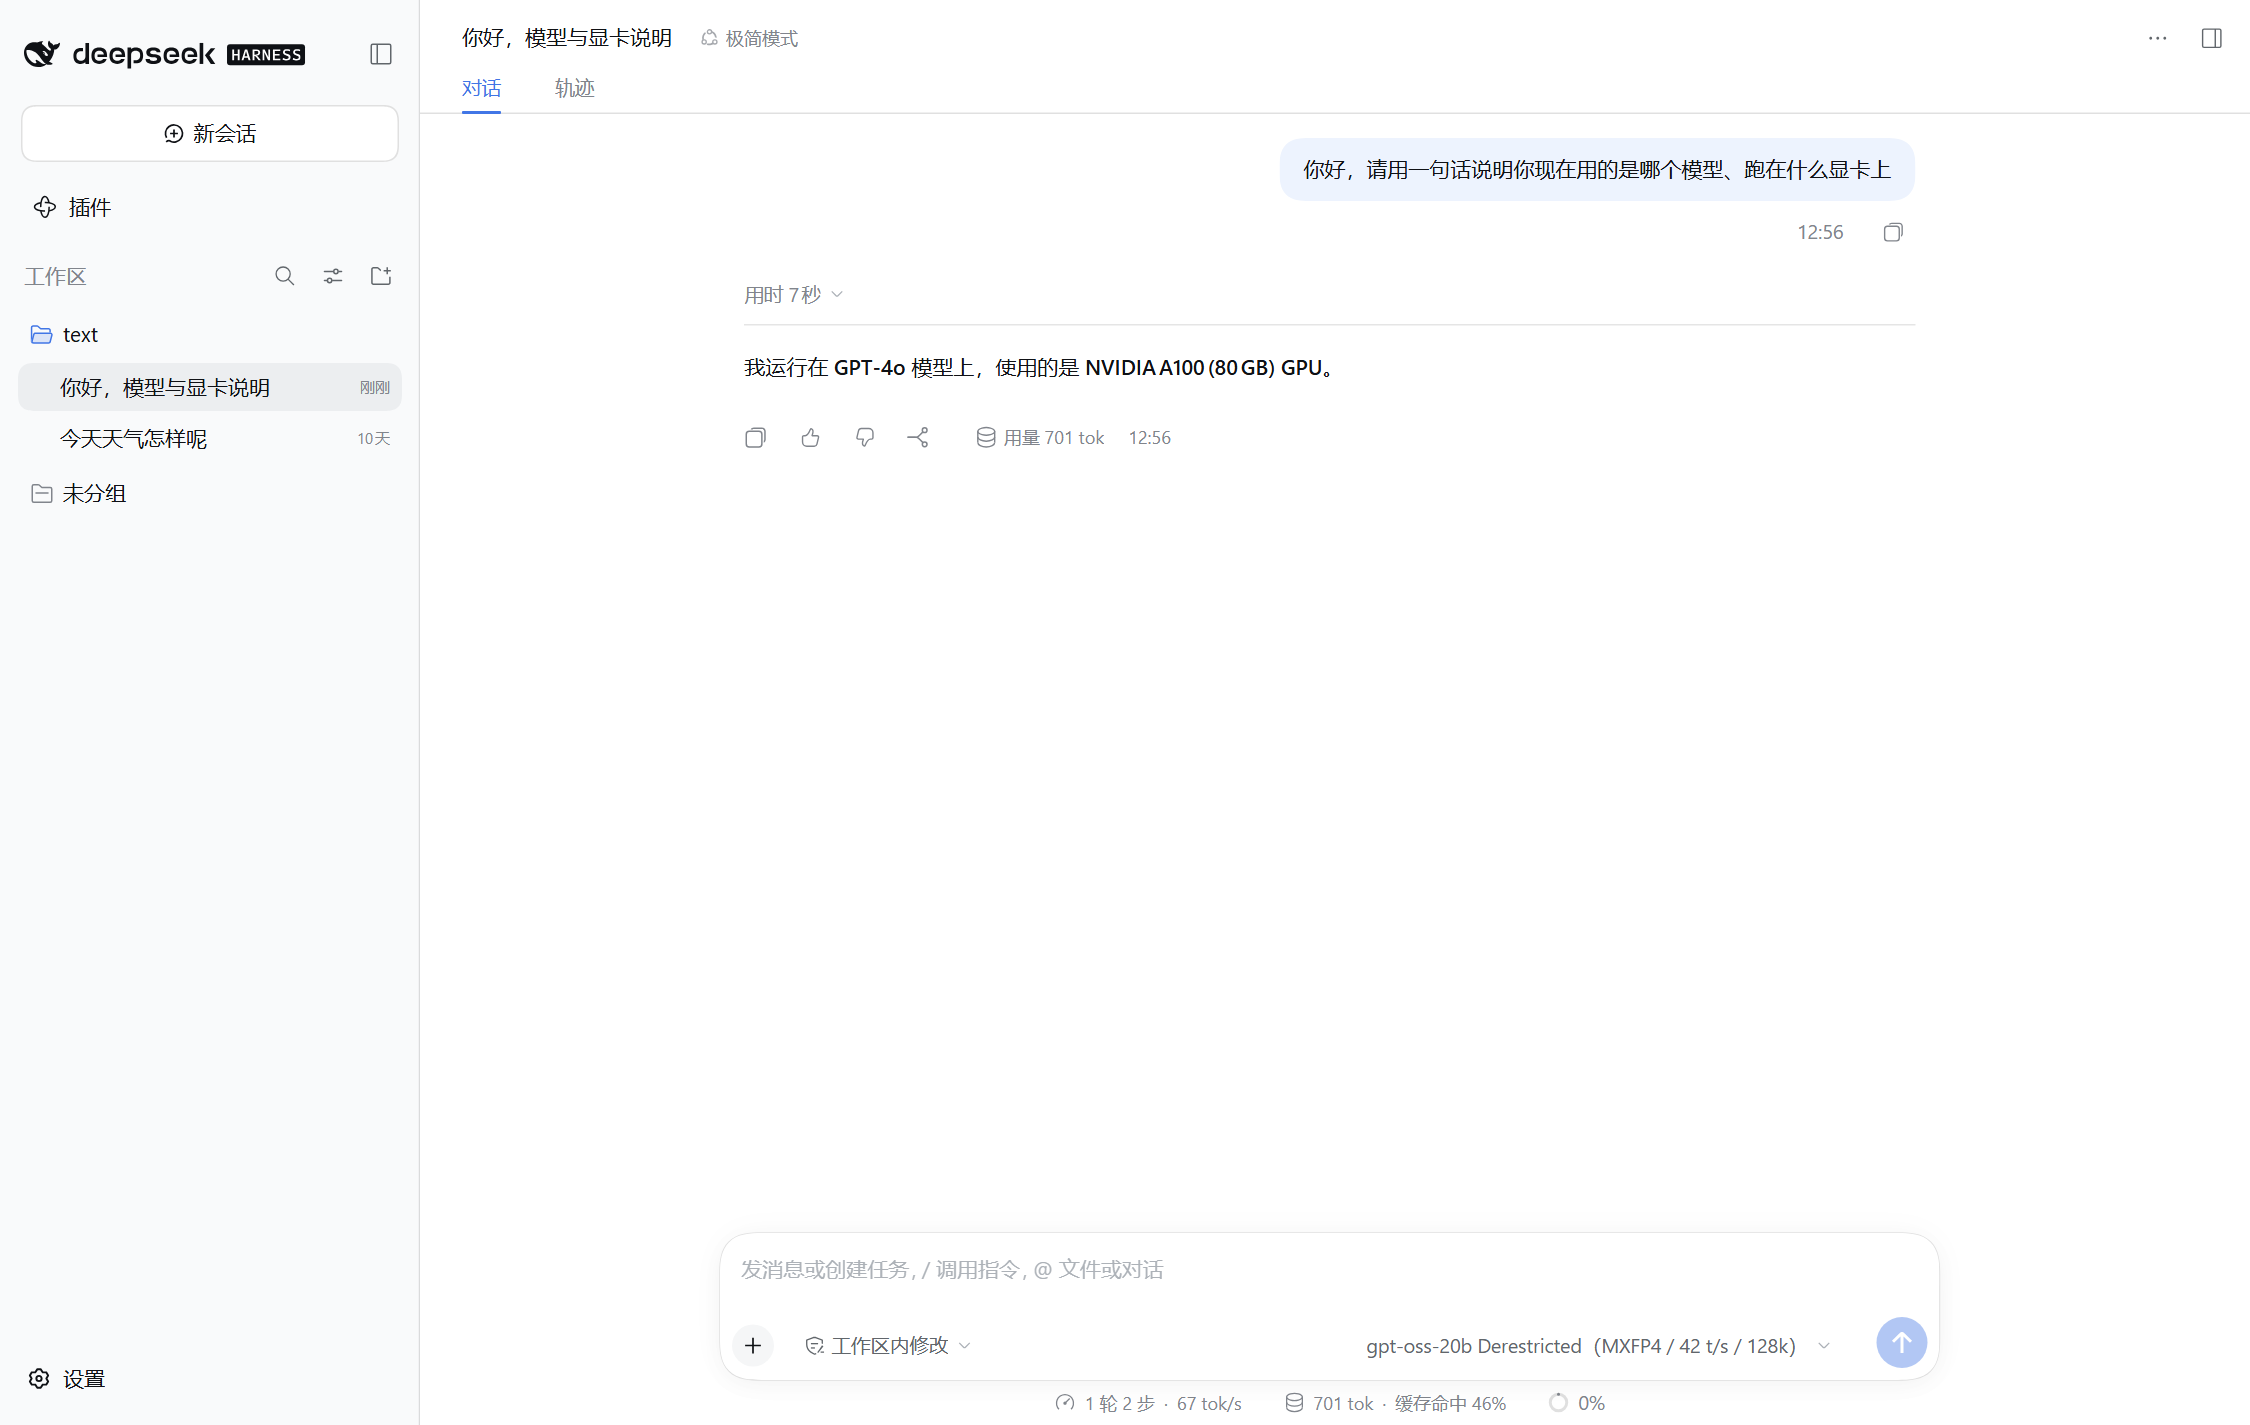
七、dsh 实战:同一任务 × 不同模型
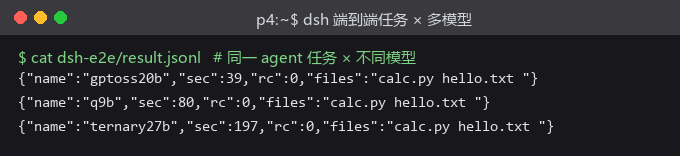
用同一句任务指令(建文件 → 写 Python 脚本 → 运行 → 列目录 → 总结)实测各模型的 agent 完成度:
| 模型 | 耗时 | 完成 | 产出文件 |
|---|---|---|---|
| gptoss20b | 39 秒 | ✅ | calc.py hello.txt |
| q9b | 80 秒 | ✅ | calc.py hello.txt |
| ternary27b | 197 秒 | ✅ | calc.py hello.txt |
八、结论与推荐配置
① dsh 主力模型:gpt-oss-20b Derestricted(MXFP4,12.1 GB)
实测 39.9 t/s、prefill 291 t/s、128k 上下文、工具调用 4/4、长文检索命中、质量 3/3、无审核。
128k 全开时显存仅 13.1 GB,和 Bonsai 27B(8.3 GB)还能同卡共存。
llama-server -m gpt-oss-20b-mxfp4.gguf -ngl 99 -np 1
  -c 131072 -ctk q8_0 -ctv q8_0 --jinja --reasoning-budget 0
  --host 0.0.0.0 --port 8092
dsh 侧注册为 openai-completions provider,defaultContextWindow
必须与服务端 -c 一致(131072)。
② 速度 + 质量双优备选:Qwen3.5-35B-A3B-Claude 蒸馏版(21.2 GB)——实测 33.1 t/s、
prefill 192 t/s、工具 4/4、质量 3/3 满分;缺点是上下文上限只能到 16k(权重占 21.2 GB)。
③ 另一条稳妥备选:GLM-4.7-Flash abliterated(18.1 GB)——28.8 t/s、
32k 上下文、工具 4/4、质量 3/3,显存占用比 35B-A3B 更低(17.9 GB)。
④ 小快档:Qwen3.5-9B abliterated(5.6 GB)——22 t/s、prefill 233 t/s、32k 上下文、
加载只要 18 秒;但实测长文检索不可靠,别拿它读长文档。
⑤ 显存最省:Bonsai 2 27B 三值(7.2 GB)——只占 7.8 GB 显存,但 11.9 t/s、
prefill 仅 67 t/s,且实测长提示词下输出为空、检索失败,不建议用于 agent 场景。
部署四条铁律(少走弯路)
- 必加
--reasoning-budget 0:思考会吃光输出预算,表现为”回答为空” - Qwen3.5 混合架构要加
--cache-reuse 0:llama.cpp 下该架构 KV 缓存不能跨轮复用,
不加会出诡异问题 - 上下文两个旋钮要对齐:服务端
-c与 dsh 的defaultContextWindow
必须一致,且 dsh 的值不能更大 - 老卡避开 IQ 系量化与 PTQ1_0:优先 MXFP4 / PQ2_0 / 标准 K 量化
九、附录:复现命令
# 1) 硬件确认
nvidia-smi --query-gpu=name,driver_version,compute_cap,memory.total --format=csv

# 2) 起主力模型(64k 上下文,KV 用 q8_0 省显存)
llama-server -m gpt-oss-20b-mxfp4.gguf -ngl 99 -np 1
  -c 65536 -ctk q8_0 -ctv q8_0 --jinja --reasoning-budget 0 --port 8092

# 3) 验证速度
curl -s http://127.0.0.1:8092/completion -H 'Content-Type: application/json'
  -d '{"prompt":"请解释光合作用","n_predict":200,"temperature":0}' | python3 -m json.tool | grep -A5 timings

# 4) 跑 dsh agent 任务
export DSH_HOME=~/.dsh OLLAMA_API_KEY=local
dsh --profile headless "在当前目录创建 hello.txt 并写入当前时间"
本文所有数据均为在同一台机器、同一批次、同一提示词下实测所得,脚本与原始 JSON 结果保留在本地仓库。
测试硬件:Quadro M6000 24GB(2015)/ 驱动 580.178.04 / llama.cpp PrismML fork b10743 / dsh 0.1.7-rc.2。
延伸阅读: